WRITING / BLOG
关于 AI 产品、测试与真实使用的长期记录。
这里不追求日更。我会记下一个产品判断如何形成、被什么证据改变,以及下一次可以复用的方法。
PAGE 14 / 本页首篇2026 年 8 月 31 日
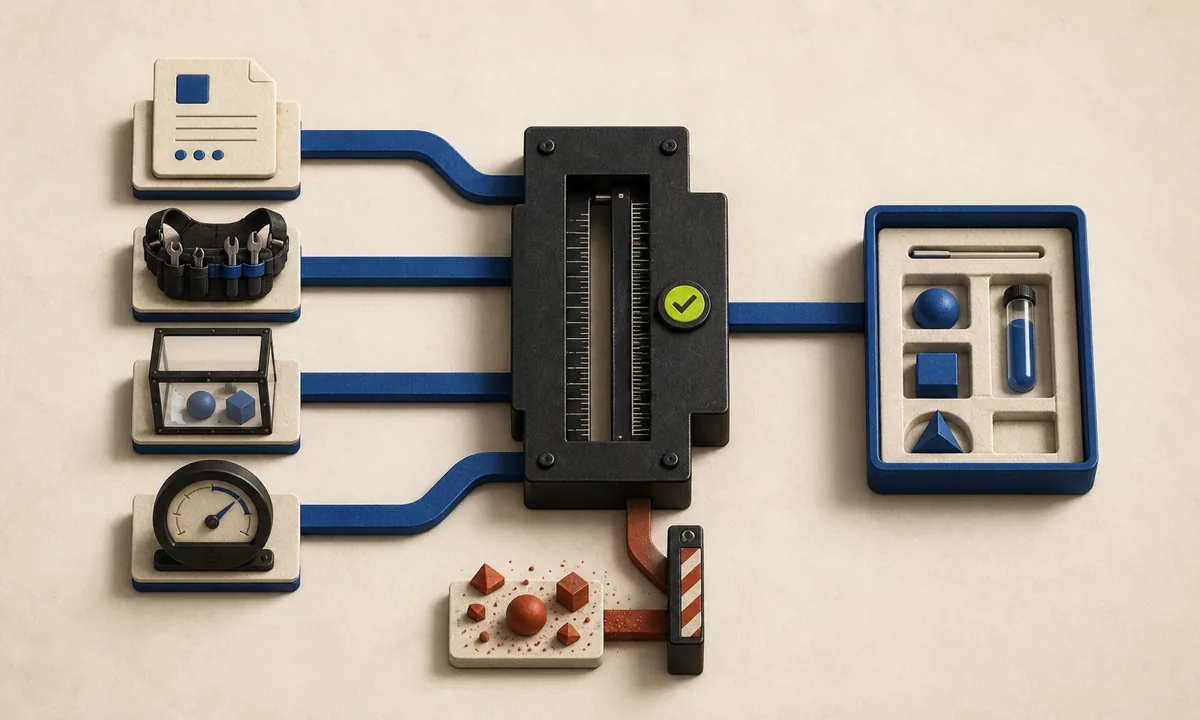
Agent 评测不是一张分数表,而是一套产品判断系统
真正有用的 Agent eval 要把任务、环境、评分器和线上失败连起来;否则测到的只是一个不完整的演示。
阅读全文ALL NOTES / 全部文章06 NOTES
自我改进的 Agent,关键是把反馈变成可合并的 Skill diff
从 Warp 在 Claude Platform 上的实践看,能复利的 Agent 不是会自动记住反馈,而是能把人类判断沉淀成可审查、可验证、可回滚的 Skill 变更。
Agent 的交付能力,为什么不只取决于模型
模型决定 Agent 能想什么;Harness 决定它能否在边界内完成、验证、恢复并留下证据。
当代码不再是瓶颈,产品交付如何重写
AI Native SDLC 的关键不在自动写代码,而在让意图、验证、风险与事故成为能持续流转的交付证据。
自动化研究找到方案后,谁有权把它带进生产?
Anthropic 的自动化对齐研究说明,Agent 可以高频提出有效方案;产品的关键是把研究迭代与生产发布拆成可审计的两套关口。
长程 Agent 如何把记忆、执行与恢复拆开
长任务不应把上下文、工具和执行环境绑在同一个容器里;可恢复的状态与可替换的执行边界更重要。