长程 Agent 如何把记忆、执行与恢复拆开
长任务不应把上下文、工具和执行环境绑在同一个容器里;可恢复的状态与可替换的执行边界更重要。
文章目录
一个 Agent 写了四十分钟代码,容器崩了。它是应该从头再来,还是应该知道已经完成了什么、哪里失败了、接下来需要什么工具?这个问题听起来像基础设施细节,实际上决定了长程 Agent 能不能成为产品能力。
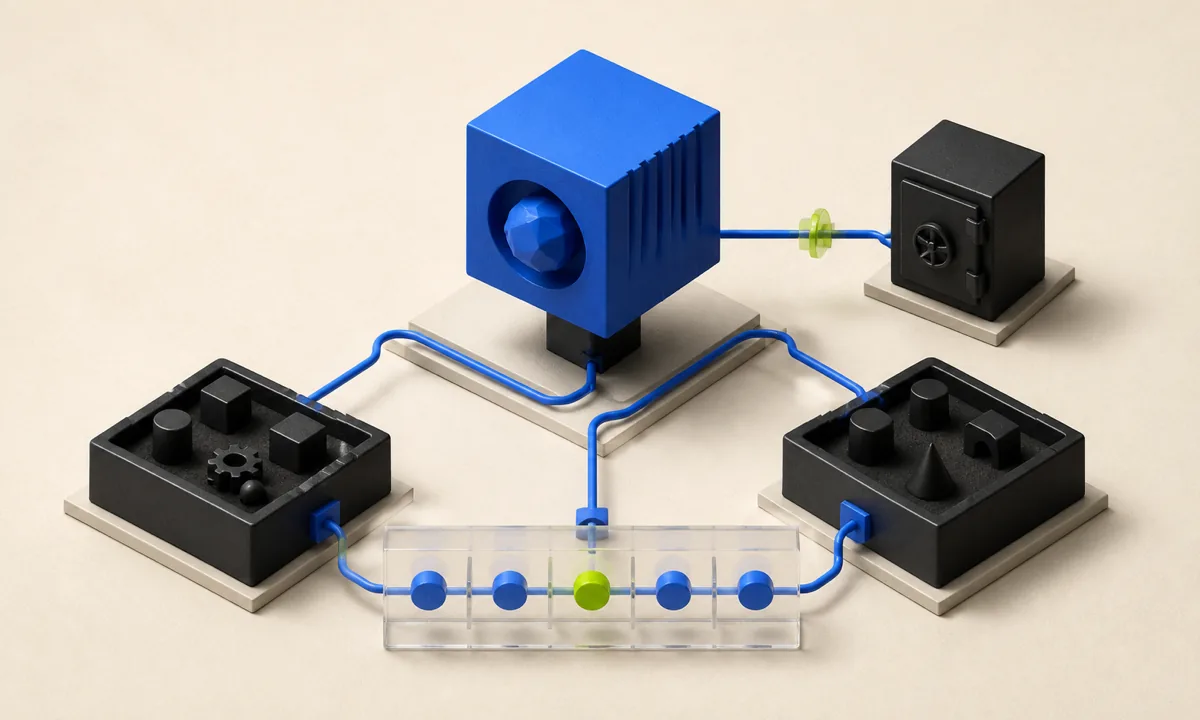
Anthropic 在 Scaling Managed Agents 中给出的回答,是将 Agent 拆成三个可独立替换的对象:session、harness、sandbox。我把它翻译成更直白的语言:记忆不能住在执行机器里,编排不能和凭证绑在一起,工具也不该成为 Agent 的永久身体。
原文从一个“宠物容器”问题出发#
Anthropic 最初把 session、harness 和 sandbox 放在同一个 container。这样文件编辑是直接系统调用,也没有跨服务接口;但容器一旦失联,任务状态随之不可见。工程师只能透过 WebSocket 事件流猜测故障来自 harness、网络还是 container,而 container 里又可能有用户数据,不适合随意进入调试。
同一耦合还带来两个产品问题。第一,harness 默认认为用户资源就在自己的容器旁边,客户若想连到 VPC,只能做网络对等或把 harness 搬到客户环境。第二,Agent 生成的非可信代码与凭证处在同一环境;prompt injection 一旦诱导读取环境变量,攻击面会超出单次任务。
作者最终将执行抽象成受控工具调用:harness 通过类似 execute(name, input) 的接口请求 sandbox 行动,失败像任何工具错误一样返回给模型;session 放到 harness 外,新的 harness 可以读取事件后恢复。这不是“把服务拆微”本身,而是让每个部件失败时有独立的恢复路径。
把“脑、手和记忆”分开#
| 组件 | 它负责什么 | 不能承担什么 |
|---|---|---|
| Session | 保存不可丢失的事件与任务状态 | 不替模型决定下一步 |
| Harness | 调用模型、组织上下文、路由工具 | 不保存唯一状态或秘密 |
| Sandbox / Tool | 运行代码、读写受限资源 | 不拥有全局凭证和最终权限 |
这组边界让失败变得可处理:sandbox 掉线是一次工具错误;harness 崩溃后可由新实例从 session 恢复;某个工具换实现时,任务接口不必跟着改写。产品上最直接的收益不是“架构更漂亮”,而是失败不再等于任务消失。
Session 不是上下文窗口#
上下文窗口只是在当前回合里模型看得见的信息,容量有限,也会被摘要或裁剪。session 则应是持续、可追溯的任务账本。
这两者混在一起时,团队常陷入两难:保留太多历史,模型越来越慢;压缩太多历史,又不知道丢掉了哪个关键决定。正确做法是让 session 保存完整事件,让 harness 决定当前回合取哪一段、如何压缩、是否回看。模型的工作记忆可以有限,产品的任务记忆不能不可恢复。
一个最小 checkpoint 不需要向量数据库。task_id、完成步骤、产物路径、未解决问题、当前 skill_version 和更新时间,已经足够让下一次会话接手。关键验收不是“文件写出来了”,而是人为中断后能否断点续作。
解耦也改变了延迟和上下文策略#
原文给出了一个很具体的性能结果:将“脑”从 container 中抽离后,sandbox 只在需要时才被 provision;在其系统里,p50 的 time-to-first-token 下降约 60%,p95 下降超过 90%。这不是模型推理变快,而是无需 sandbox 的会话不再被容器启动、仓库克隆和进程初始化阻塞。
文章还区分了 session 与上下文窗口。长任务常用 compaction、memory 文件或 trimming 处理上下文;这些动作不可避免地决定了什么被保留、什么被丢弃。Managed Agents 让完整事件留在可查询的 session 中,再由 harness 选取事件切片放回当前上下文。对产品而言,应该分别测试“任务账本是否完整”和“本回合上下文是否高效”,不能用更长上下文掩盖状态管理缺失。
权限边界要围绕动作,而不是指令#
如果 Agent 生成的代码和访问凭证在同一个环境里,prompt injection 的影响范围会被放大。Anthropic 的工程实践强调把凭证放在 sandbox 外:Agent 可以通过受控代理完成操作,却不直接获得 token。
对产品团队来说,可以把权限设计成一张行动表:
| 动作 | 默认策略 | 何时升级 |
|---|---|---|
| 读取项目代码、运行测试 | 自动允许 | 涉及敏感目录时记录 |
| 修改工作区文件 | 允许但受目录限制 | 批量修改或测试失败 |
| 推送、部署、外发消息 | 默认禁止 | 人类审核后单次授权 |
| 删除数据、改变权限 | 默认禁止 | 明确负责人审批 |
这里的重点不是让 Agent “知道危险”,而是让危险动作在结构上不能被它独自完成。
用稳定接口,替代对模型弱点的硬编码#
模型升级后,旧 harness 的某些补丁会过时:曾经为防止任务过早结束而做的上下文重置,可能反而成为额外开销。因此架构应该稳定在接口层,而不是稳定在某一种模型的行为假设上。
我会让产品对外承诺少数长期接口:创建任务、读取事件、执行受控动作、提交产物、请求升级。模型如何规划、上下文如何压缩、某个 sandbox 如何实现,都应该允许迭代。这样换模型不是迁移整个系统,而是替换一个可以被测量的部件。
产品验收应该测恢复,而不是只测首跑#
长程 Agent 至少要增加三类测试:
- 中断恢复:在不同步骤杀掉进程,确认不会重复执行不可逆动作。
- 工具失效:模拟超时、限流和返回异常,确认 Agent 记录证据并有界重试。
- 权限拒绝:让 Agent 请求禁止动作,确认它会说明阻塞并正确升级。
首跑成功只能证明一次路径可行。恢复、替换和拒绝动作都正确,才说明这个 Agent 经得住真实运行环境。
来源与边界#
- 事实与架构术语来自 Anthropic 工程文章 Scaling Managed Agents: Decoupling the brain from the hands。
- “脑、手和记忆”的表达、权限行动表与验收建议是我的产品化转译;它们不是 Anthropic 产品的公开接口说明。