Agent 的交付能力,为什么不只取决于模型
模型决定 Agent 能想什么;Harness 决定它能否在边界内完成、验证、恢复并留下证据。
文章目录
同一个模型,换一套工具、测试和权限配置,任务完成率可能完全不同。这个现象很容易被误解成“提示词写得更好”。但当 Agent 要读资料、改文件、调用工具、处理失败并交付一个可复核结果时,提示词只解决了其中很小的一段。
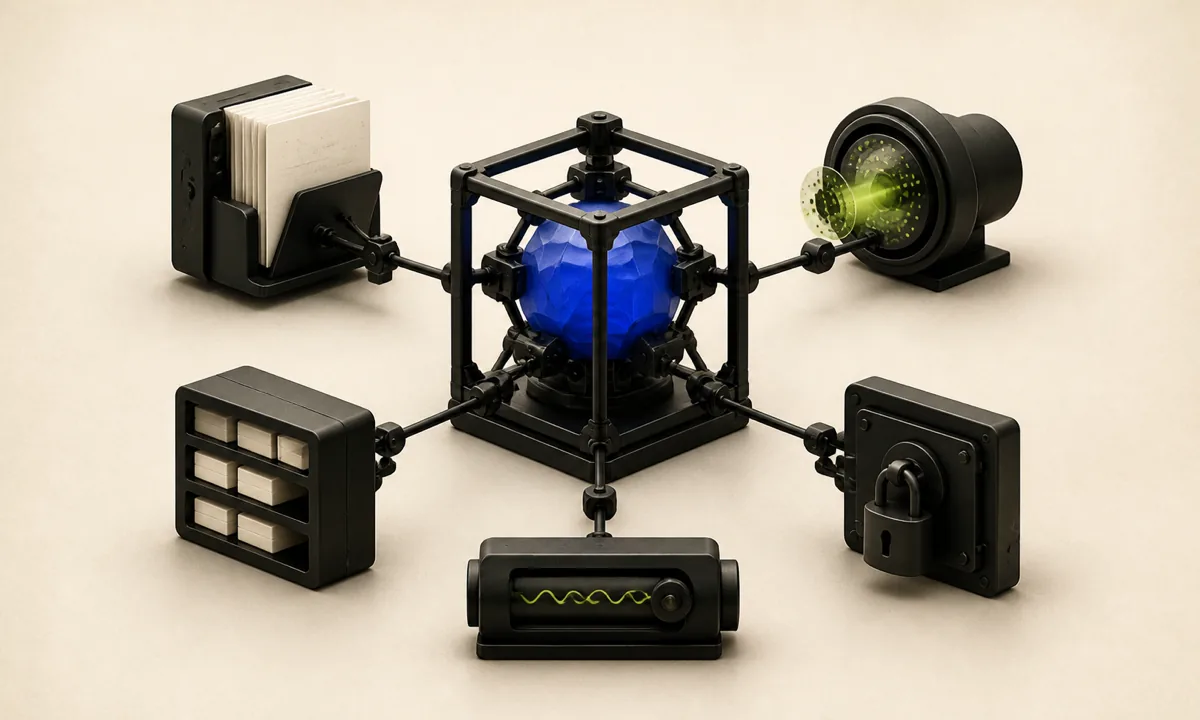
我更愿意把 Agent 写成一个产品公式:Agent = Model + Harness。模型提供理解和推理;Harness 则定义行动边界、执行循环、状态保存、结果验证和故障证据。前者决定它能提出什么方案,后者决定方案是否能安全地变成结果。
先看证据:同一模型名,不等于同一套 Agent#
这不是一句抽象口号。HARNESS 资料引用的 GAIA 公开结果里,Claude Sonnet 4.5 在 HAL Generalist Agent 设置下为 74.55%,在 HF Open Deep Research 设置下为 30.91%。两者相差 43.64 个百分点;公开榜单还显示二者的成本不同,分别约为 178.20 美元和 451.84 美元。
这组数字不能被偷换成“只改了一行 prompt 就带来 43.64 分”。两个系统的模型服务方式、工具、流程与评测协议都需要逐项核对。但它足以说明一个常被忽略的事实:模型名称不是产品能力的充分描述,运行它的系统同样进入结果。
更接近受控对照的是 LangChain 对 Terminal-Bench 2.0 的公开实验:在保持 gpt-5.2-codex 不变时,团队通过 prompt 和 middleware 等 harness 层调整,把结果从 52.8% 提升到 66.5%,当时榜单名次从 Top 30 到 Top 5。这个案例仍然是单个团队的工程结果,不该外推成任何任务都会提升 13.7 分;但它给了产品团队一个可操作的方向:先从 trace 中找失败模式,再对工具描述、验证循环与状态管理做可回归的改动。
不要把一次顺利演示,当作可交付能力#
聊天式演示的成功条件很宽:给出一个看起来合理的答案即可。生产任务的成功条件更严格:任务是否完成、证据是否充分、出错后是否停止、下次能否恢复,缺一项都不能叫交付。
因此,我会先问四个问题,而不是先问“该换哪个模型”:
- Agent 开始前读到了哪些可执行规则?
- 它完成后由什么机制验证,而不是自己宣布成功?
- 中断、超时或工具失败后,状态能否被恢复?
- 出现危险动作时,系统会拒绝、升级,还是只能祈祷模型谨慎?
这四个问题对应的是系统能力,而不是模型性格。
六层控制面,分别解决六种失败#
一份《Harness Engineering》汇编材料把 Harness 拆成六层,这个拆分对产品设计很实用:
| 层 | 要解决的失败 | 最小实现 |
|---|---|---|
| Guides | 已知规则没有被执行 | AGENTS.md、任务模板、边界清单 |
| Sensors | 流畅输出被误认为正确 | 测试、lint、schema、人工抽检 |
| Agentic Loop | 失败后无限重试或草率结束 | 计划→执行→验证→修复/升级 |
| Memory | 会话一断,工作从零开始 | plan.md、checkpoint、决策日志 |
| Permissions | 模型把不该做的动作做了 | 最小权限、预算、人工批准 |
| Observability | 出错后不知道为什么 | 结构化日志、成本归因、熔断告警 |
这里最值得坚持的顺序是:能用确定性检查解决的,不要先用 LLM 评审;能用环境限制阻断的,不要只在提示词里警告。 这不是保守,而是让系统对模型波动更不敏感。
把失败沉淀到正确的层级#
一个常见坏习惯是:Agent 出错后,在下一次对话里多加一句“请仔细一点”。这会修复当前交互,却不会让系统获得能力。
我会用一条升级路径处理重复失败:第一次先复现并记录;第二次写入 Guide;如果错误已经可以形式化,就把它升为阻断式 Sensor;如果后果不可逆,则升为权限或审批边界。修复越接近运行环境,复发概率通常越低,但建设成本也越高。
这就是 Harness 的复利:人类 review 不再只是消耗,而是把某一类错误永久移出未来任务的可选空间。
不同失败,应该进入不同的工程队列#
把所有问题都归因于“模型不够聪明”,会让团队错过更便宜的修复。可以把真实失败先分成四类:
| 现场证据 | 更可能的根因 | 优先改哪里 |
|---|---|---|
| Agent 忘了运行固定检查 | 规则没有成为任务输入 | Guide 或任务模板 |
| 输出看起来合理但结果不对 | 缺少可执行验收 | Sensor 或测试 |
| 已完成工作在中断后丢失 | 状态只存在上下文里 | checkpoint 或任务账本 |
| Agent 尝试部署、删除或外发 | 权限暴露过宽 | 身份、工具代理与审批 |
分类的目的不是把问题塞进六层表格,而是让修复可以被验证。若加了一条 Guide 后同类错误仍出现,下一步不是再把句子写得更强硬,而是检查 Agent 是否实际读取了它,或者将规则升级成能够阻断的检查。
指标不该只看 Token#
调用次数、Token 和耗时是成本信号,不是产品结果。更值得追踪的是:
- Verified completion rate:启动的任务中,有多少通过了预先定义的验证;
- Rework rate:有多少结果仍需人重新做;
- Escalation quality:高风险与不确定任务是否在正确时机升级;
- Cost per verified result:得到一个可用结果究竟花了多少模型、工具和人工成本。
尤其是升级率,不能盲目追求低。一个从不升级的 Agent,也可能只是把风险藏进了自信的回答里。
从哪里开始#
不需要先搭一个复杂的多 Agent 平台。选一个每周重复、正确性可验证、失败代价可控的任务:先写清构建和测试命令,接入一个确定性检查,限制写入范围,再记录任务结果。每次真实失败后,只强化最薄弱的一层。
模型会继续变强,今天有效的 prompt 也会过期。真正可持续的资产,是一套能随着失败持续更新、又能保留边界与证据的运行控制面。
来源与边界#
- 核心框架参考 Harness Engineering:Agent = Model + Harness。该材料为行业资料汇编;其中案例数字应在正式引用前回到原始论文或官方工程文章核验。
- GAIA 数字可在 HAL 的 Claude Sonnet 4.5 结果页 交叉查看;Terminal-Bench 的 52.8%→66.5% 实验来自 LangChain 的 harness profile 报告。
- 本文的六层映射、指标取舍和落地顺序,是我面向 AI 产品团队的产品化推演,不代表上述材料的实证结论。