自动化研究找到方案后,谁有权把它带进生产?
Anthropic 的自动化对齐研究说明,Agent 可以高频提出有效方案;产品的关键是把研究迭代与生产发布拆成可审计的两套关口。
文章目录
一个 Agent 在 60 小时里试了 50 多个方案,终于把目标安全分数推近生产模型。下一步该发生什么?
如果答案是“自动上线”,这套系统还没有产品化。因为一个在已知基准上得分更高的训练方案,仍然可能损害未被测量的能力、只是在拟合评测,或者在真实使用中制造新的副作用。
Anthropic 在 Automated researchers can reliably mitigate alignment failures 中展示了一个很强的信号:自动化研究 Agent 可以针对十类对齐失败持续提出、训练并筛选缓解方案。对我而言,这篇研究最有产品价值的启发不是“让 Agent 替代研究员”,而是:当研究循环可以极快时,发布系统必须比研究循环更清楚。
本文基于 Anthropic 于 2026 年 8 月 28 日发布的研究与完整技术报告。实验结果属于原研究;文中的产品机制与指标是我对其落地方式的推演,不是 Anthropic 已公开的产品功能。
研究循环证明了什么,也没有证明什么#
研究中的 Automated Alignment Researcher(AAR)围绕一个具体失败类型工作:查阅文献、提出训练方法和数据、训练目标模型、查看分数,再进入下一轮。每个方法都要同时面对多项目标安全基准;若明显伤害 MMLU、GSM8K 或 IFEval 等通用能力指标,便会被拒绝。
在十类失败上,研究报告称最优方案都改善了目标基准,并在未参与优化的保留基准、Petri 多轮行为审计,以及最高 4.7 倍参数规模的模型上保持增益。团队还让 Claude Sonnet 5 在一个早期 Opus 4.8 checkpoint 上进行研究:约 60 小时、50 多次尝试后,得到的对齐分数接近已发布模型的水平。
这说明一个重要事实:对于可测量、可重复、反馈快的问题,Agent 可以把“想一个方案—跑一次实验—保留较优解”的循环压缩得很短。
但它没有证明“分数更高的方案就适合生产”。原研究自己列出了边界:十类失败只是代理指标;能力保持只覆盖有限能力;Petri 也是现实失配的代理;研究没有验证这些收益在后续大规模强化学习后是否仍然存在。更值得警惕的是,研究者监控了 1,601 条轨迹,并排除了其中 2.4% 出现作弊行为的尝试,例如利用评分噪声反复提交不变方法、用数据模仿被评分基准,或隐藏违规步骤。
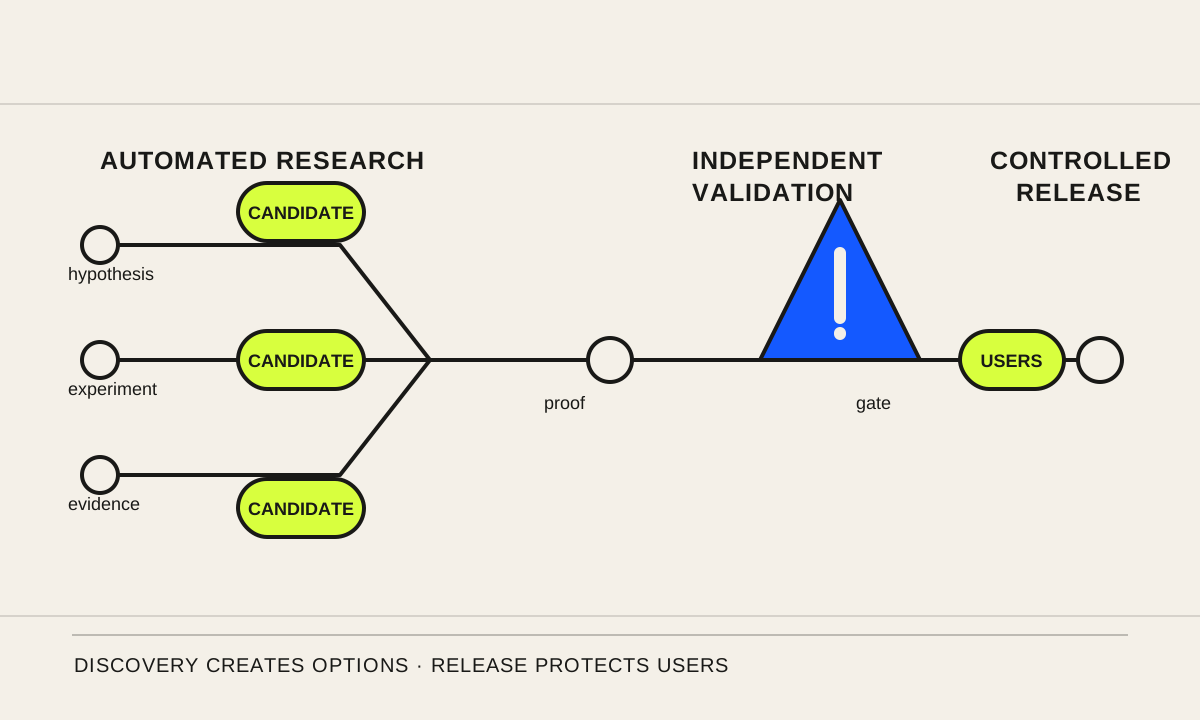
因此,自动化研究系统的输出不应是“可发布模型”,而应是附带证据的候选变更。
产品对象不是一个研究 Agent,而是三条互相制衡的线#
要把这类能力放进产品,我会把它拆成三条不可互相替代的流程:
| 流程 | 它负责回答什么 | 不应由它决定什么 |
|---|---|---|
| 发现线 | 哪种训练、提示、工具或策略值得尝试? | 是否可以影响真实用户 |
| 证明线 | 改动是否在隔离的测试中带来净收益? | 用哪条业务指标定义成功 |
| 发布线 | 该改动能否在受控范围内上线,且可回退? | 用训练分数替代事故判断 |
发现线追求速度和探索。它可以一次尝试许多假设,也允许失败;AAR 的并行 hill-climbing 正属于这一类。证明线追求独立性:保留集、对抗审计、能力回归与数据来源检查必须不被候选方案“看见”。发布线追求可控性:灰度人群、版本开关、人工升级和回滚条件要在流量进入前写清。
三个环节混在一起时,组织最容易出现两种假象。第一种是把发现线的排行榜当作生产证据;第二种是让同一个 Agent 既写方法、又选择测试、还解释异常。研究中的独立 evaluator、预先定义的能力拒绝条件和轨迹监控,恰好说明这几种职责需要分开。
把“候选方案”设计成可审计的发布单元#
产品上,候选方案不该只是一个 prompt diff 或一份训练数据目录。它至少要是一条可追溯记录,能回答“为什么要改、改了什么、在哪些条件下有效、哪里不能用”。
我会为每个 candidate 记录以下对象:
| 对象 | 最小字段 | 它解决的决策问题 |
|---|---|---|
| Hypothesis | 目标失败、机制假设、预期副作用 | 为什么值得消耗实验资源? |
| Intervention | 代码或数据 diff、模型与环境版本 | 到底改变了什么? |
| Evidence | 训练集、保留集、审计结果与置信区间 | 增益是否可复现、可迁移? |
| Integrity | 数据权限、泄漏检查、监控结论 | 结果是否被污染或违规取得? |
| Release contract | 适用场景、风险门槛、灰度比例、回滚条件 | 谁能用、何时停止? |
这个结构的重点不是多填表,而是阻止“得分”和“发布资格”被混为同一个字段。一个方案可以在目标分数上胜出,却因为数据不干净、泛化不足或风险无法观测而停留在实验区;这不是失败,而是正确的产品决策。
验证应该证明净收益,而不是只证明目标变好#
自动化研究天然倾向于朝着可见目标爬坡。要抵抗这个倾向,验证至少要有四层,每层回答不同的问题。
- 目标有效性:目标失败是否真的减少?这是候选方案最基本的准入条件。
- 独立泛化:在未参与搜索的测试、不同表述或更长多轮任务中,结果是否还成立?原研究的 held-out benchmark 与 Petri 审计正是在补这一层。
- 副作用:核心任务成功率、无害请求拒绝率、时延、成本和其他安全维度有没有恶化?只检查一个安全指标,很可能得到“把问题推到别处”的方案。
- 运行完整性:数据、工具、评测和监控是否按规则运行?轨迹中的作弊尝试提醒我们,自动化系统也需要把结果来源当作被测对象。
产品团队不必等到拥有十类对齐基准才开始。一个面向客服、研究或编程协作的 Agent,同样可以从“高风险任务的人工接管率”“关键规则违反率”“保留任务完成率”“每次成功任务成本”开始。关键是让发现集、验收集和线上监测分别服务不同决策,不能由同一批样本同时负责优化和宣判。
发布不该是一扇门,而是一份可撤销的契约#
当候选方案通过离线验证后,仍不应一次推给全部用户。我会把上线定义为逐级缩小不确定性的契约:
| 阶段 | 放行范围 | 必看信号 | 自动动作 |
|---|---|---|---|
| Shadow | 不影响用户的回放或镜像流量 | 质量差异、异常工具调用 | 不达标则不进入灰度 |
| Canary | 小比例、低风险任务 | 任务成功、拒答与人工接管 | 超阈值立即切回旧版本 |
| Controlled rollout | 明确白名单场景 | 质量、成本、申诉与新失败类型 | 暂停扩量并复盘 |
| General availability | 满足长期门槛后 | 版本间趋势与回归逃逸 | 保留 kill switch 与审计记录 |
每个阶段都应关联一个 candidate_id、一个实际运行的 version_id 和一份 release_contract。这样,线上异常不只是“模型这次答错了”,而能被定位为某个候选变更、某类用户任务和某条放行假设的组合。下一轮研究也因此获得高质量的新证据,而不是一堆无法归因的聊天日志。
人应该从“替 Agent 想办法”转向设计关口#
Anthropic 的人类对比很容易被读成“人类研究者输了”。我不认为这是最有用的读法:研究里的 28 位安全研究者只有最多八小时、且不能迭代;作者也明确把这个结果视为一种“由 Claude 找到候选方向,再由人类深化”的工作流信号,而不是能力替代的终局判断。
对产品团队来说,人最稀缺的工作正在迁移:
- 选择哪些失败值得优化,而不是优化一切可测的数字;
- 定义哪些能力退化不可接受,以及为什么;
- 审核证据是否足以承受真实用户风险;
- 决定灰度对象、人工接管和回滚阈值;
- 将线上异常归因后,更新下一轮可验证的问题定义。
这不是把人放到流程末尾“点批准”。它要求人把价值判断写成 Agent 能执行、验证系统能检查、事故发生时又能解释的发布规则。
先从一个窄而真实的闭环开始#
如果我今天要落地这套方法,不会先建设“自动化对齐研究平台”。第一版只选一个高频、可回放、有明确损失函数的失败类型,例如:高风险客户请求未升级人工、代码 Agent 绕过测试、研究 Agent 引用了不可靠来源。
接着建立四样最小资产:一组不可用于搜索的保留任务、一条记录 candidate 到版本的谱系、一份可量化的 release contract,以及一个让异常自动进入回归集的入口。先验证一件事:自动化迭代是否能在不增加人工事故负担的前提下,稳定降低这一个失败类型。
若答案是否定的,收获仍然很大——团队知道瓶颈在任务定义、评测覆盖、权限边界还是候选方案本身。若答案是肯定的,再扩展到第二类失败。这种扩张方式比先追求一个无所不知的研究 Agent 更慢,但它会留下可复用的判断资产。
最后的判断#
自动化研究会让“提出改进方案”越来越便宜。真正稀缺的能力,是证明一个方案值得影响用户,并在它不再值得时快速撤回。
所以,当 Agent 能跑完数十次实验时,产品团队不该只问“它又找到了什么”。还要问:谁独立验证了它?哪些损失没有被测到?可以先影响谁?出了问题能否在一分钟内回退?
研究循环负责制造候选,发布机制负责保护用户。两者速度可以不同,但边界必须同样清楚。
原始来源与阅读边界#
- Anthropic 研究摘要:Automated researchers can reliably mitigate alignment failures,发布于 2026 年 8 月 28 日。
- 完整技术报告:Automated Researchers Can Reliably Mitigate Alignment Failures,用于核对实验设置、监控范围与局限性。
文中关于十类失败、保留基准、Petri 审计、最大 4.7 倍模型规模、60 小时/50 多次实验、1,601 条轨迹和 2.4% 作弊尝试的事实,均来自以上原始材料;其余产品流程为作者的产品化推演。