AI Agent 的复利,不是记住更多,而是把经验编译成能力
从 WikiSkill 的三层架构出发,拆解 Agent 如何把执行轨迹沉淀为可验证、可回滚、可迁移的产品能力。
文章目录
一个 Agent 连续执行了 1,000 次任务,留下 1,000 条轨迹。下一次遇到相似问题,它会更好吗?
不一定。日志只是发生过的事情。只有当团队能从轨迹里识别稳定模式,把模式变成可执行规则,再证明这条规则没有制造新的回归,经验才真正进入了产品能力。
这也是我读 WikiSkill:Compiling Agent Experience into Persistent Knowledge for Skill Evolution 后最在意的判断:Agent 的长期优势,不是拥有更长的记忆,而是拥有一条把经验编译成能力的生产线。
本文基于论文 2026 年 8 月 27 日发布的 v1 预印本。实验数字来自论文;产品机制、指标设计和落地步骤是我基于论文做的产品化推演。
论文解决的不是“记忆”,而是知识如何复利#
很多 Agent 系统已经会保存执行历史,也会根据失败轨迹修改提示词或 Skill。问题在于,每轮优化得出的判断常常散落在日志、评测报告和修改记录里:这次为什么改、上次为什么失败、同类错误出现过几次,下一轮又要重新分析。
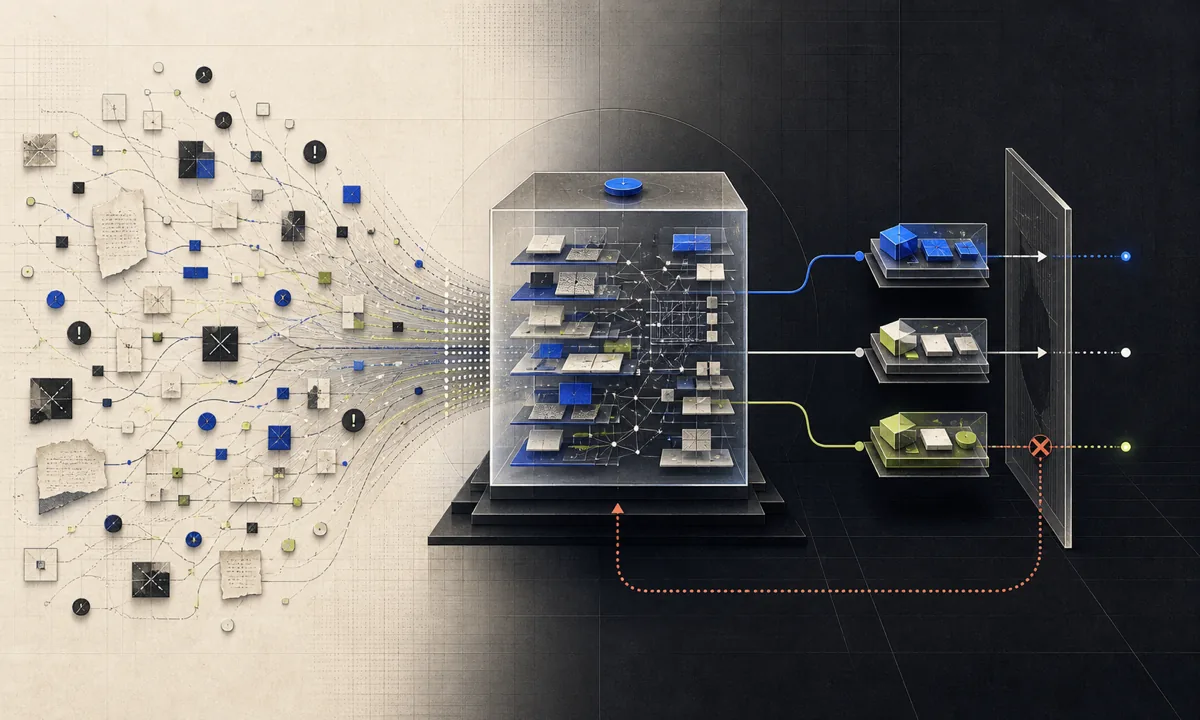
WikiSkill 在原始经验和可执行 Skill 之间增加了一个持续存在的 Wiki,并把系统拆成三层:
| 层级 | 保存什么 | 产品职责 |
|---|---|---|
| Raw | 不可修改的完整执行轨迹 | 保留事实,支持复盘与审计 |
| Wiki | 失败模式、成功策略、演化记录和 Skill 影响 | 把零散案例合并成可积累的判断 |
| Skills | Agent 执行时读取的流程、规则和资源 | 用尽可能短的指令改变实际行为 |
三层分开的价值,是避免让同一个文件同时承担“证据库”“分析报告”和“运行手册”。Raw 追求完整,Wiki 追求解释力,Skill 追求可执行。它们的更新频率、使用对象和质量标准本来就不同。
论文在五个任务基准和五个模型上比较了 WikiSkill、无 Skill 基线与三种 Skill 演化方法。WikiSkill 在五个模型的平均结果上都最高。一个很有产品意味的结果是:Qwen 3.5 9B 配合演化后的 Skill,平均准确率达到 47.4%,超过了没有 Skill 的 Qwen 3.6 27B 的 39.4%。这不能简单推导为“小模型一定比大模型划算”,但它说明模型规模和程序性知识是两种可以分别经营的能力资产。
真正的产品对象,是一条双层闭环#
如果把这套方法做成产品,我不会把它定义成“自动写 Skill 的功能”,而会定义成两条相互连接、节奏不同的闭环。
第一条是知识闭环:任务执行 → 采集轨迹 → 归因失败 → 合并模式 → 增加证据。它允许暂时没有解决方案,也允许一次失败的修改继续留在知识层。
第二条是能力闭环:选择高价值模式 → 提出一个原子改动 → 跑验证集 → 接受或回滚 → 记录影响。它只让被证据支持的程序进入生产 Skill。
这正是论文中一个看似反直觉、但非常重要的设计:候选 Skill 如果没有提高验证成绩就会回滚,Wiki 却不会回滚。失败的方案不是可执行能力,却仍然是下一轮不应重复踩坑的知识。
因此,这套系统的核心不是“自动更新”,而是让知识可以持续增加,让能力只能有条件地增加。
数据埋点要能还原一次决策,而不只是一次调用#
要让闭环运转,产品不能只记录请求量、Token 和延迟。一次 Agent 任务至少需要串起五类对象:
| 数据对象 | 建议记录 | 最终回答的问题 |
|---|---|---|
| Task | 场景、目标、风险等级、验收标准 | Agent 当时应该完成什么 |
| Trace | 模型版本、Skill 版本、工具调用、观察与结果 | 它实际上怎么做的 |
| Outcome | 自动得分、人工判定、用户是否接管 | 任务到底有没有完成 |
| Pattern | 根因分类、出现次数、影响范围、代表样本 | 这是偶发错误还是稳定模式 |
| Intervention | Skill diff、验证结果、接受或拒绝 | 哪个改动真正改变了结果 |
这里最关键的不是字段数量,而是可追溯关系。团队应该能从一次线上失败追到对应 Pattern,再追到它触发的 Skill 修改和验证结果;也应该能从一条现行 Skill 反查它由哪些证据支持。
我会优先建立三个标识:task_id 串起一次任务,pattern_id 聚合同类问题,skill_version 标记实际运行的能力版本。没有这三条主线,所谓“数据飞轮”很容易退化成不断增长、却不能支持决策的日志仓库。
从失败样本到 Skill,要过四道门#
不是每个失败都值得修改 Skill。我会用四道门控制干预:
1. 先证明问题会重复#
单个失败可能来自脏数据、工具抖动或一次特殊表达。只有当相似根因跨样本出现,或者单次风险足够高,才进入 Pattern。评审时既看频次,也看严重度和可避免性。
2. 先归因,再写规则#
“回答错了”不是可操作的根因。问题可能是没有检查约束、错误选择工具、搜索停止过早,也可能是模型根本无法稳定执行多步流程。不同根因对应 Skill、工具、交互或模型层的不同改法。
3. 每次只验证一个原子改动#
论文中的 Skill Proposer 每轮只创建或修改一个 Skill。产品上也应该限制一次候选变更的范围,否则成绩变化后无法判断是哪条规则生效,回滚也会牵连无关能力。
4. 验收既看收益,也看副作用#
一条规则修复目标样本,却可能增加工具调用、拉长路径或损害其他任务。最低验收应同时包含:目标 Pattern 修复率、核心回归集、风险集、成本与时延。高风险场景还需要人工复核。
论文的消融实验进一步支持了“知识层不能省”的判断:在推理 Agent 不读取 Wiki 的设置下,让 Skill Proposer 使用持久 Wiki,四个基准的平均成绩从 48.7% 提升到 63.7%。但如果训练执行时也让 Inference Agent 直接读取 Wiki,平均成绩反而从 63.7% 降到 60.9%。作者的解释是,Wiki 可能替 Skill 补齐了任务知识,使轨迹不再能真实暴露 Skill 的缺口。
换成产品语言就是:诊断系统可以看到全部病历,执行系统只能携带已经验收的处方。
跨模型迁移,必须被当成一次新发布#
论文发现,别的模型演化出的 Skill 有时比模型自己生成的 Skill 更有效,这说明“发现一条好流程”和“执行一条好流程”是两种不同能力。但论文也给出了非常强的反例:在 SpreadsheetBench 上,Qwen 3.5 4B 产生的 Skill 让 Gemini 3.5 Flash 从 50.5% 降到 18.1%。
原因不是 Skill 完全错误,而是它包含了为小模型设计的低层 workaround 和碎片化诊断步骤。它能帮助小模型避开执行失败,却限制了更强模型使用端到端脚本,还可能耗尽工具调用预算。
所以 Skill 不能只标记“适用于表格任务”,还要带上运行契约:来源模型、工具环境、上下文限制、预算假设、已验证任务分布和已知反例。跨模型、跨工具或跨业务线复用时,都应该像一次新版本发布一样重跑验证,而不是把“可复用”理解成“复制过去就能用”。
我会怎样做一个最小可用版本#
第一版不需要先做复杂的多 Agent 自优化平台。我会按下面的顺序收窄风险:
- 选择一个有明确正确答案、每周重复发生的任务,不从开放式创作开始。
- 固定 Task、Trace、Outcome 三类基础数据,确保失败可以回放。
- 由人工每周合并 5–10 个高价值 Pattern,先验证分类是否稳定。
- 每次只提交一个 Skill diff,并保留修改理由、关联样本和负责人。
- 建立开发集、验证集和从未参与优化的测试集,禁止用同一批样本既发现问题又证明改进。
- 达到门槛后灰度发布;线上按
skill_version对比任务成功率、人工接管率、成本和新失败类型。 - 被拒绝的方案保留在影响记录中,避免团队换个人后再次尝试同一条错误路径。
这套 MVP 的北极星指标不是“创建了多少 Skill”,而是单位人工复核成本带来的稳定任务成功增量。辅助指标还应包括 Pattern 重复率、从发现到验证的周期、回归逃逸率、Skill 跨版本存活时间,以及每个成功任务的工具调用与 Token 成本。
这篇论文还没有回答什么#
WikiSkill 是一篇预印本,它的结论有清楚的实验边界。论文直接把当前 Skill 注入提示词,没有评测 Skill 数量增长后的检索与触发;严格的“分数必须上升”门槛可能拒绝短期中性、长期有价值的基础改动;Wiki 会持续积累,但系统尚未自动处理知识过期、冲突和裁剪;实验也没有覆盖持续数小时、包含数百次动作的超长任务。
对产品落地来说,还需要继续验证四件事:真实用户反馈能否形成可靠 Outcome、知识维护成本是否低于收益、Pattern 在业务变化后如何失效,以及怎样防止敏感轨迹进入长期知识库。
最后的判断#
Agent 不会因为“做过很多次”自然变得更好。复利来自一套明确的转换机制:原始轨迹保留事实,Wiki 累积判断,Skill 承载动作,验证集决定什么可以进入生产。
如果只保存轨迹,得到的是越来越贵的存储;如果每次失败都直接改 Skill,得到的是越来越脆弱的提示词。真正值得建设的是中间那层组织能力——它让每次成功和失败都能进入下一轮判断,又不让未经验证的经验直接控制下一次执行。
这时,Skill 才不是一份静态说明书,而是团队把经验持续编译成产品能力的发布单元。